最近在检查 Bing Webmaster Tools(必应网站管理员工具)时,发现一个比较奇怪的问题:网站被收录了大量搜索页面,而且搜索关键词完全不是自己网站的内容。
例如:
- search?wd=m.quicknews.pl
- search?wd=www.bitget-ag.com.cn
- search?wd=wap.viewzone.pl
- search?wd=bookmoon.pl
- search?wd=gate-ta.com.cn
- search?wd=www.ludashi-jp.com.cn
这些URL都有一个共同特点,就是通过网站搜索功能生成,参数 wd 后面跟着各种陌生域名。
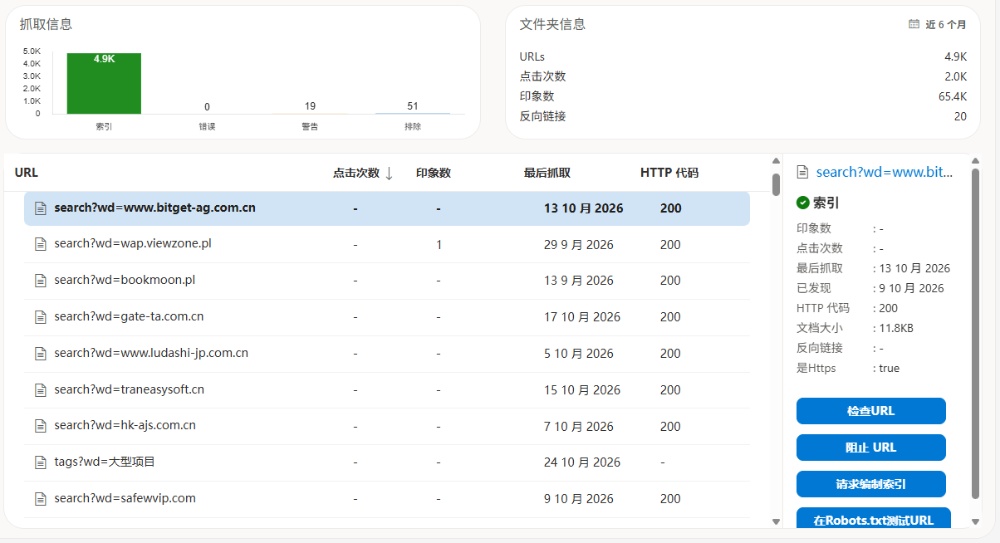
我平时并没有搜索这些内容,也没有主动创建过这些页面。看着这些URL,第一反应就是网站是不是被人利用了。
这些陌生URL是从哪里来的?
搜索引擎不会无缘无故生成这些URL。一般来说,可能有以下几个来源:
- 网站内部链接被利用。 网站搜索框通常会生成带参数的URL。如果有人通过程序批量提交搜索请求,或者网站存在可以被外部调用的搜索接口,就可能产生大量带有陌生关键词的搜索页面。
- 外部网站留下了链接。 其他网站可能通过友情链接、垃圾外链、评论区或者自动生成的页面引用了这些搜索URL。Bingbot发现这些链接后,就可能顺着链接访问。
- 网站被脚本批量访问。 有些程序会自动请求网站搜索接口,尝试生成大量不同的搜索结果页面。如果搜索功能没有限制,攻击者可以轻松制造成千上万个带参数的URL。
具体来源不能仅凭URL判断,需要结合服务器访问日志、Bing的URL检查结果和外链数据进一步排查。
为什么搜索页面会被收录?
这里有一个容易忽略的问题:网站搜索结果页通常没有太多独立内容,但只要服务器正常返回200状态码,页面又没有设置NOINDEX,搜索引擎就有机会将其纳入索引。
例如:https://www.example.com/search?wd=bookmoon.pl,即使搜索结果为空,网站仍然可能返回一个完整的HTML页面。对于搜索引擎来说,这就是一个可以访问的URL。
如果有人不断提交不同的搜索关键词,就会产生大量内容相似、价值很低的页面。这类URL数量一多,还可能浪费搜索引擎的抓取资源。
我是如何处理这个问题的?
检查之后,我准备从搜索功能、页面索引和服务器安全几个方面处理。
1. 给搜索结果页添加NOINDEX
如果网站搜索页面没有SEO价值,可以直接在搜索结果页的HTML头部添加:
<meta name="robots" content="noindex, follow">这样可以告诉搜索引擎不要将搜索结果页收录,同时允许继续跟踪页面上的链接。
2. 限制搜索接口的滥用
给搜索请求增加频率限制,必要时增加验证码,对异常请求进行拦截。对于明显不合理的搜索关键词,也可以进行过滤,避免有人利用搜索接口批量生成垃圾页面。
3. 检查服务器访问日志
重点查看 /search 请求的访问频率、IP地址、User-Agent以及请求时间。如果短时间内出现大量不同的 wd 参数,而且请求行为高度相似,就需要警惕自动化程序批量访问。
4. 处理已经收录的垃圾URL
对于确定不需要收录的搜索页面,确保返回正常页面并带有NOINDEX。对于已经永久删除的页面,可以返回404或410状态码。
同时可以利用Bing Webmaster Tools的URL检查工具查看抓取和索引情况,必要时使用URL删除工具处理已经收录的结果。
暂时不打算在robots.txt里禁止爬取search页面,因为robots.txt主要控制抓取,并不能代替NOINDEX。单纯禁止抓取,反而可能让搜索引擎无法读取页面上的NOINDEX标签。
最后说几句
这次经历也提醒我,网站SEO不能只关注文章有没有被收录,还要关注搜索引擎到底收录了哪些URL。如果网站搜索页面被大量垃圾关键词占据,说明搜索功能可能存在被滥用的风险。
建议大家定期检查Bing Webmaster Tools和Google Search Console,特别是带有 ?wd=、?q=、?keyword= 等参数的页面。
搜索页面本来是方便用户查找内容的功能,千万别让它变成别人批量制造垃圾URL的工具。


